Ми дедалі частіше чуємо про те, що та чи інша компанія впроваджує Spec-Driven Development (SDD), а найчастіше саме OpenSpec, у свої процеси розробки ПЗ. Десь це поки що експеримент кількох команд, а десь специфікація вже стає обов'язковою точкою входу в будь-яку задачу.
При цьому мало хто з розробників розуміє, що саме означає розробка з AI-агентом від специфікації, чим специфікації допомагають на практиці та які особливості з'являються під час роботи саме з OpenSpec. Нерідко все уявлення про підхід зводиться до того, що перед написанням коду агент має створити ще кілька Markdown-файлів.
Тож влаштуйтеся зручніше. У цій статті ми нарешті розкладемо по поличках, навіщо потрібні всі ці документи, розберемося, як виглядає процес розробки від специфікації, і спробуємо реалізувати нову функціональність за допомогою OpenSpec.
У цій статті я розглядаю OpenSpec лише на етапі розробки: від отримання вимог до реалізації. Пошук і перевірку продуктових ідей, а також узгодження вимог за межами репозиторію залишимо за дужками.
Трохи теорії
Якщо ви вже добре уявляєте, що таке специфікація, вимога та критерії приймання, сміливо пропускайте цю главу й переходьте одразу до розділу про OpenSpec. Тут ми ненадовго зупинимося на базових термінах, щоб далі говорити однією мовою.
Почнімо з поняття «вимога». Вимога — це опис того, що має робити система. Гарна вимога описує спостережуваний і перевірний результат.
Вимоги бувають різного рівня:
Бізнес-вимоги пояснюють, навіщо компанії зміна та якого результату вона хоче досягти
Користувацькі вимоги описують, що користувач має мати можливість зробити за допомогою системи
Системні вимоги визначають, як система має поводитися, щоб виконати користувацькі та бізнес-вимоги
Нефункціональні/технічні вимоги фіксують вимірювані характеристики й обмеження реалізації: продуктивність, навантаження, технології, протоколи, архітектурні правила та вимоги до інфраструктури
Розробник здебільшого працює із системними та нефункціональними/технічними вимогами: або реалізує вже сформульовані, або формує їх на основі користувацьких і бізнес-вимог.
Взагалі під час опису задачі намагаються витримувати єдиний рівень абстракції вимог. Тому часто говорять про їхню ієрархію: бізнес-вимоги задають мету, користувацькі — очікуваний сценарій, а системні та нефункціональні/технічні поступово уточнюють, як система має цю мету підтримати. Але щоб не перетворювати статтю на академічний виклад, давайте розберемося на прикладі.
Припустімо, ми розробляємо систему для ветеринарної клініки. На рівні бізнес-вимоги її власник формулює мету: клініці потрібна система обліку власників тварин, самих тварин та історії їхніх візитів.
Із цієї мети з'являються користувацькі вимоги. Наприклад, адміністратор клініки має мати можливість вести реєстри власників, тварин і візитів. Тут також описуємо, яку інформацію користувач хоче зберігати в кожному з них.
Далі формуємо системні вимоги: як саме адміністратор створює власника, додає йому домашніх тварин, реєструє візит і редагує його дані. На цьому рівні вже можуть з'явитися користувацькі сценарії та mockup-и інтерфейсів.
Окремо формуємо нефункціональні/технічні вимоги: одночасно із системою можуть працювати до десяти адміністраторів, а час відгуку інтерфейсу не має перевищувати 100 мс. Сюди ж можуть входити обмеження на технології, протоколи інтеграції та архітектуру. Найважливіше, щоб кожна вимога була зрозумілою та її можна було перевірити.
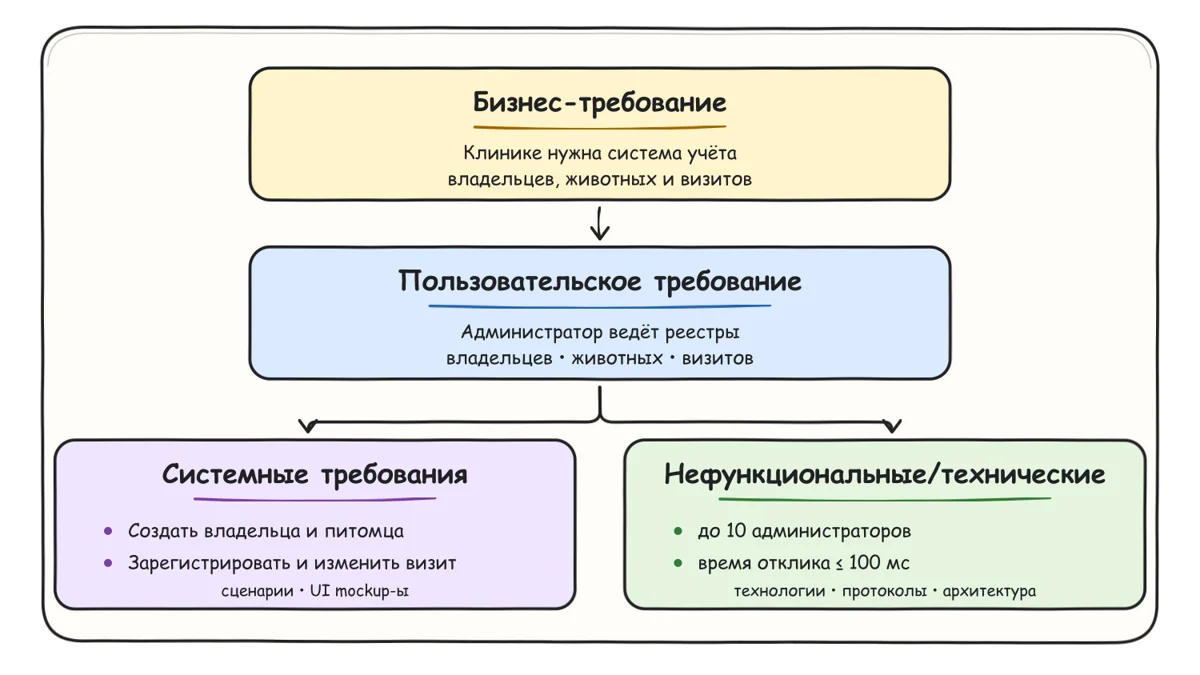
Отже, набір пов'язаних вимог приблизно одного рівня абстракції — хоча на практиці витримати цей рівень вдається не завжди — і можна назвати специфікацією.
Зафіксуймо: специфікація — це документ або набір документів, у якому зібрано пов'язані вимоги до системи. Залежно від рівня вона може описувати бізнес-цілі, користувацькі можливості, поведінку системи або нефункціональні та технічні обмеження. Головне, щоб вимоги не суперечили одна одній, залишалися на порівнянному рівні абстракції та описували перевірний результат.
OpenSpec
OpenSpec — це відкритий фреймворк для Spec-Driven Development. Він допомагає фіксувати вимоги у специфікаціях і підтримувати їхню актуальність на всьому життєвому циклі: від моменту, коли ідея нового функціоналу тільки виникла в голові продукту, до її реалізації в застосунку. В OpenSpec кожна вимога описує очікувану поведінку системи та доповнюється сценаріями з критеріями приймання.
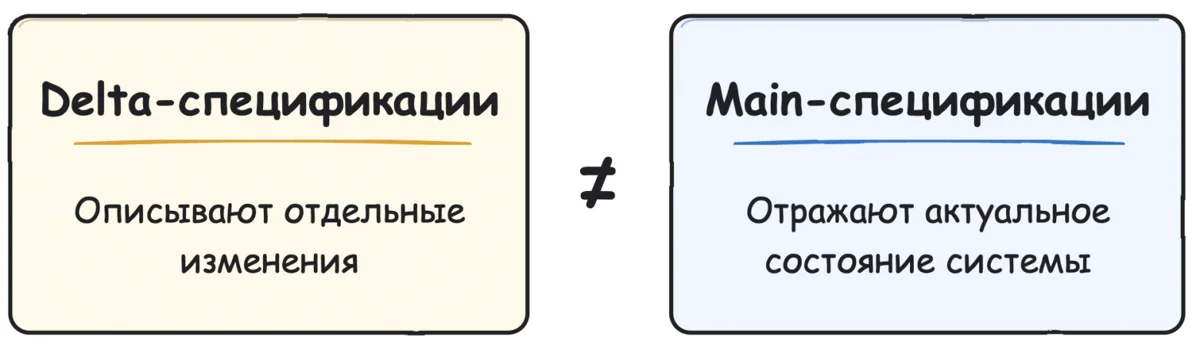
В OpenSpec є два види специфікацій: main specs і delta specs. Main specs зберігають опис поточної поведінки системи та виступають джерелом істини (source of truth). Delta specs створюються для конкретної зміни та описують лише різницю між поточним і бажаним станом: які вимоги потрібно додати, змінити, видалити або перейменувати.
Сама специфікація складається з набору вимог (requirements), і кожна вимога має містити хоча б один сценарій (scenario). І вимоги, і сценарії оформлюються окремими заголовками: ### Requirement: і #### Scenario: відповідно. Вимога описує одну спостережувану та перевірну поведінку системи, формулюється через SHALL або MUST і не містить деталей реалізації. Наприклад: The system SHALL return the collection of all stored veterinarians.
Сценарій, своєю чергою, задає критерії приймання вимоги та описує конкретні умови й очікуваний результат у форматі GIVEN/WHEN/THEN — або WHEN/THEN, якщо передумов немає. Наприклад, сценарій List with existing records визначає, що запит GET /api/vets за наявності ветеринарів має повернути 200 OK і JSON-масив з усіма записами.
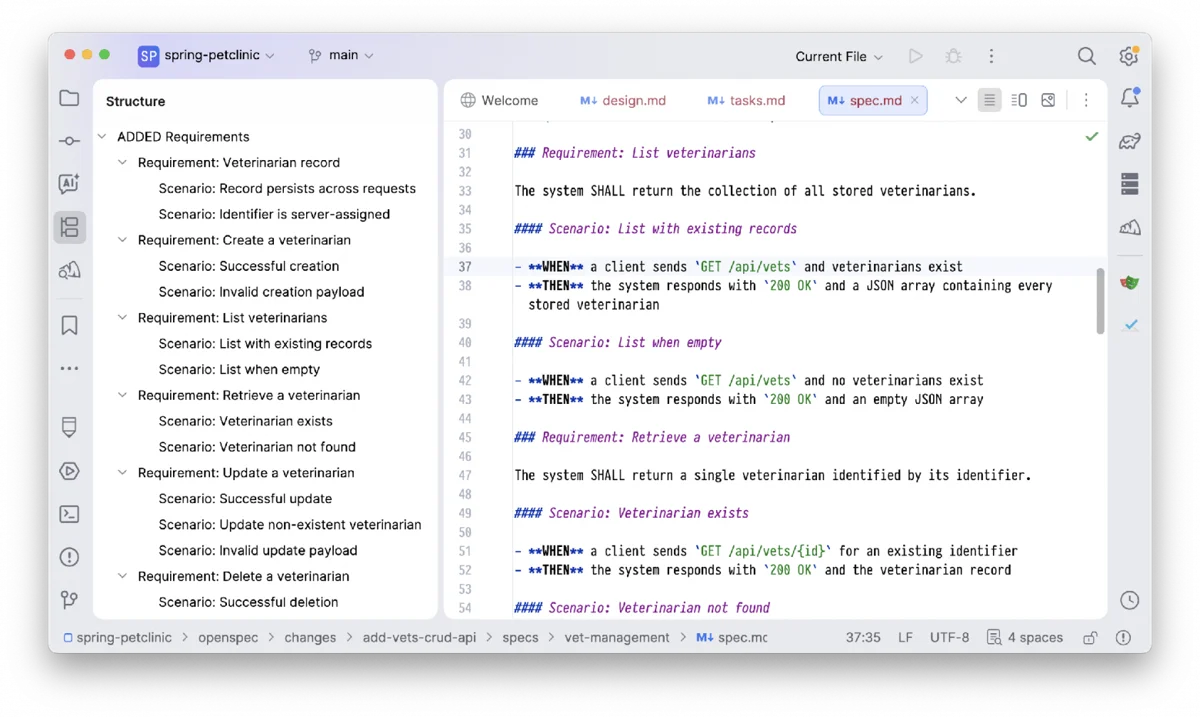
На перший погляд може здатися, що ці вимоги та сценарії надто очевидні. Але, по-перше, очевидні речі теж потрібно десь зафіксувати. По-друге, OpenSpec згенерував їх самостійно — видно, вони йому все-таки потрібні. А оскільки вони коректно описують, як має працювати наш застосунок, залишимо їх як є.
Звісно, в епоху AI руками ми пишемо хіба що промпти — та й ті іноді просто наговорюємо. Тому саме час розібратися, як генерувати специфікації за допомогою OpenSpec.
OpenSpec Change
Будь-яке доопрацювання в OpenSpec здійснюється через створення «зміни» (change). Усередині неї OpenSpec зберігає delta spec і пов'язані з доопрацюванням артефакти. За замовчуванням це proposal — фіксує намір і межі зміни; design — описує технічне рішення; tasks — задає послідовність робіт, якої буде дотримуватися агент. Цей список не вичерпний: за потреби його можна доповнити артефактами, які потрібні саме вам.
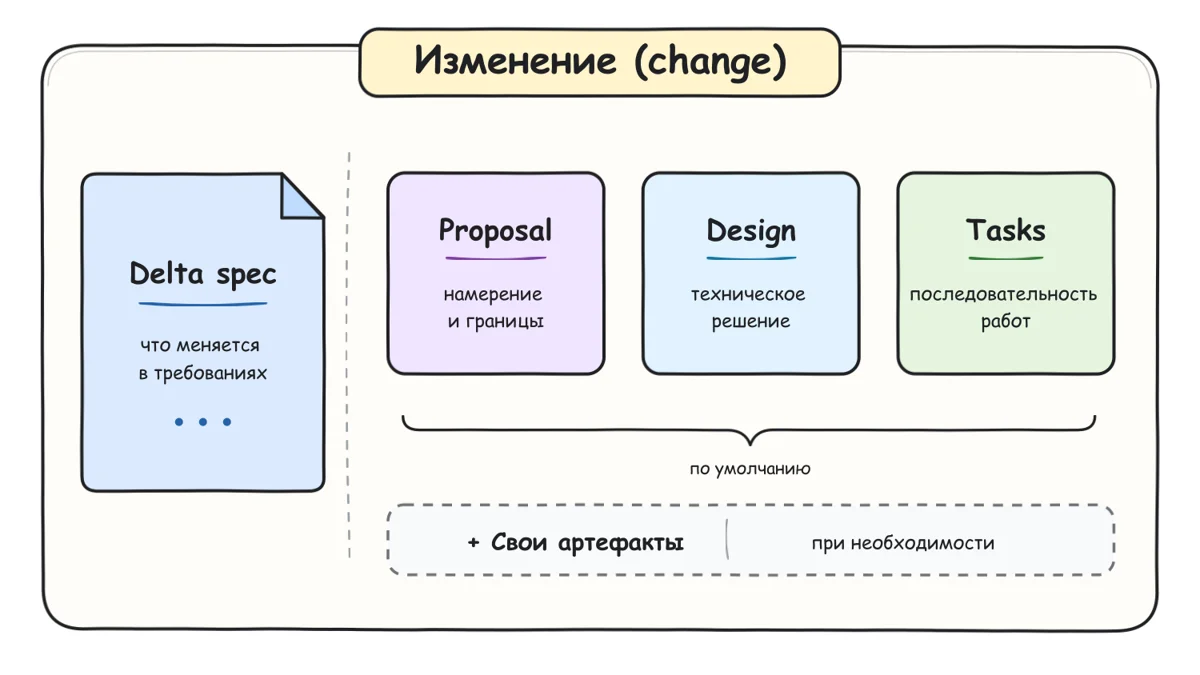
Давайте створимо нашу першу зміну. Як приклад розроблятимемо типове застосування — ветеринарну клініку. За основу візьмемо чистий проєкт на Spring Boot 4.1.1 і Java 26 з підключеними Spring Web MVC, Spring Data JPA, Validation і PostgreSQL. Поки що це порожня заготовка без доменної моделі та endpoint-ів. Першою зміною додамо зберігання інформації про ветеринарів і CRUD REST API для роботи з ними.
Але перш ніж створювати першу зміну (change), необхідно ініціалізувати OpenSpec у репозиторії.
Для цього нам знадобиться OpenSpec CLI. Інструкцію зі встановлення для вашої платформи та ОС можна знайти в офіційній документації.
Далі виконуємо команду openspec init і вибираємо агентів, яких використовуватимемо під час розробки застосунку.
Що відбулося під капотом? openspec init створив у корені репозиторію каталог openspec/, у якому зберігатимуться конфігурація проєкту, актуальні специфікації та майбутні зміни. Заодно CLI встановив для вибраних агентів skill-и та slash-команди. Специфікацій на цьому етапі ще немає: init лише підготував структуру проєкту та інструкції, за якими працюватимуть агенти.
Далі пройдемо повний цикл зміни, що складається з трьох етапів: Propose, Apply і Archive. Кожен із них розберемо окремо.
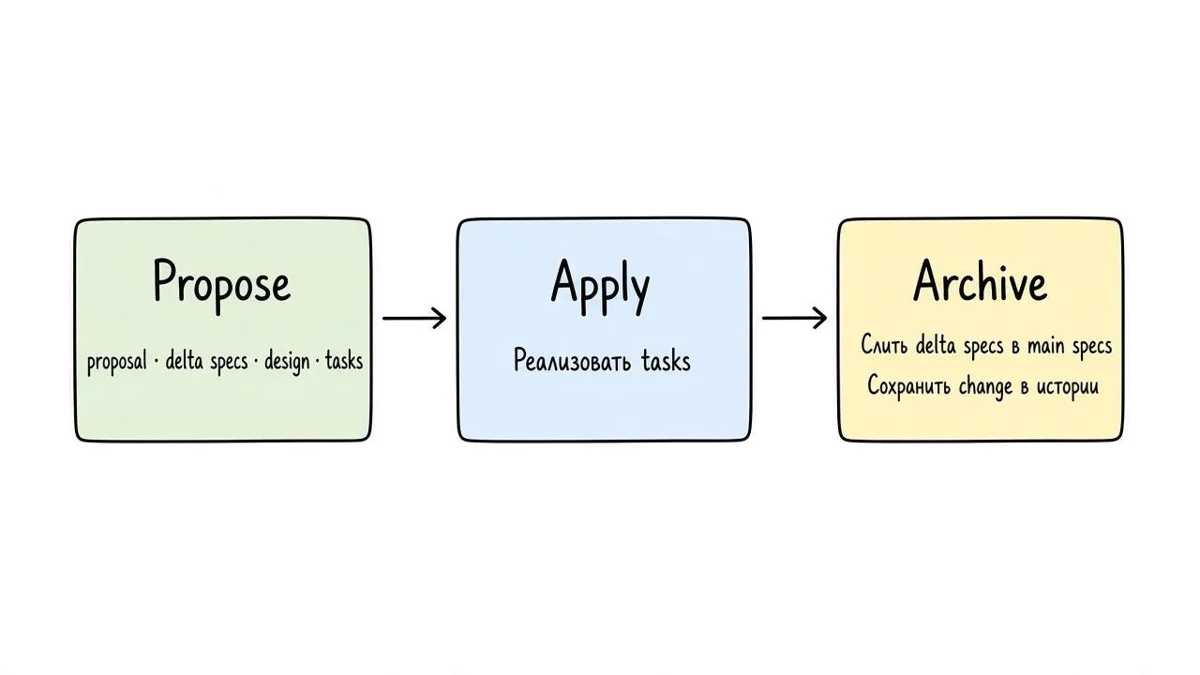
Propose
Щоб створити першу зміну, скористаємося командою /opsx:propose і передамо їй промпт з описом того, що хочемо змінити в застосунку.
/opsx:propose Додай модель для зберігання інформації про ветеринарів і CRUD REST API для створення, отримання, зміни та видалення записів про них.У реальному проєкті опис задачі зазвичай уже є в тікеті або на сторінці Wiki/Confluence, тому в /opsx:propose мені достатньо вказати посилання. Оскільки мій агент підключений до цих корпоративних систем, він сам завантажить вихідні вимоги та вже на їхній основі створить зміну (change).
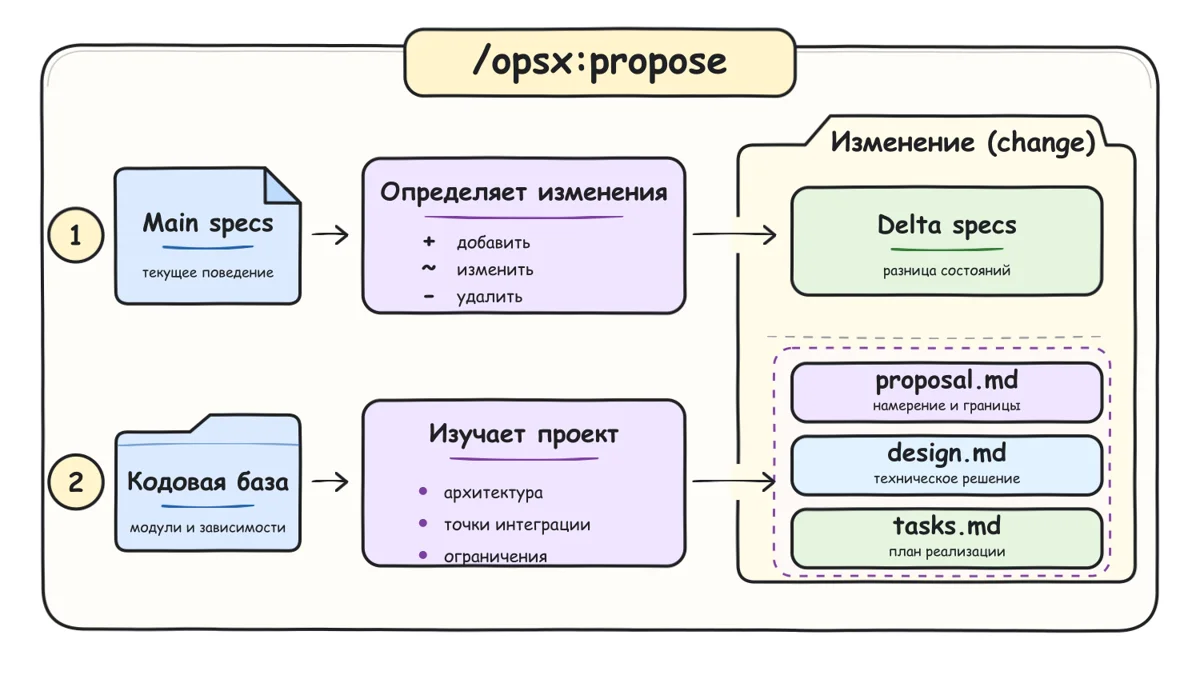
У межах propose агент спочатку дивиться, що вже зафіксовано в main specs. Якщо специфікації є, він визначає, які з них зачепить зміна: які вимоги потрібно додати, які — уточнити, а які — прибрати. Якщо main specs ще немає — як у нашому чистому Spring Boot-проєкті, — агент описує нову поведінку з нуля. Результат цієї роботи — delta specs: вимоги та сценарії, що описують лише різницю між поточною та бажаною поведінкою системи.
Далі агент розбирає поточну кодову базу: які модулі та залежності вже є, куди логічно вбудувати нову функціональність і які технічні обмеження не можна ігнорувати. На цій основі він готує design.md — технічний дизайн зміни — і tasks.md — план робіт, за яким агент реалізовуватиме задачу на наступному кроці.
Коли propose завершується, перевіряємо згенеровані артефакти. Я читаю їх у такому порядку: proposal.md → specs → design.md → tasks.md. Потрібно переконатися, що агент правильно зрозумів вихідну задачу і що запропонована реалізація відповідає нашим очікуванням: за інтерфейсом, користувацькими сценаріями та внутрішньою архітектурою. У tasks.md окремо перевіряю, що в плані є задачі, пов'язані з перевіркою бар'єрів (guardrails): юніт- та інтеграційні тести, Checkstyle, архітектурні перевірки ArchUnit, coverage і мутаційне тестування PITest. Крім того, переконуюся, що є задача на рев'ю коду іншим агентом: якщо основну розробку вів Claude Code, рев'ю робить Codex, і навпаки.
У моїй ситуації мені часто доводилося просити агента вносити одні й ті самі правки від зміни до зміни на етапі propose. Зменшити кількість правок і скоригувати поведінку агента можна кількома способами:
Додати «керівний» prompt у CLAUDE.md або AGENTS.md вашого агента
Покласти інструкції в openspec/AGENTS.md — OpenSpec сам підтримує цей файл
Описати правила в конфігураційному файлі OpenSpec — openspec/config.yaml
Створити власну схему артефактів
Артефакти перевірено, правки зафіксовано — можна переходити до безпосередньої реалізації.
Apply
Щоб агент почав розробляти специфікацію, достатньо викликати /opsx:apply. Він візьме tasks.md вибраної зміни та йтиме за пунктами плану. Але перед цим я роблю кілька попередніх кроків.
Спочатку комічу change-специфікацію. На цьому етапі в репозиторії ще немає коду фічі — лише proposal, delta specs, design і tasks. Якщо під час реалізації щось піде не так, до узгоджених артефактів завжди можна повернутися.
Далі створюю окремий worktree і веду в ньому всю розробку. Так поточна реалізація не перетинається з іншими незавершеними змінами, а за потреби розробку кількох специфікацій можна вести паралельно.
Потім очищаю контекст поточної сесії або заводжу нову. Сесія propose уже встигла обрости обговоренням, коментарями та проміжними правками, а для реалізації агенту це не потрібно і може бути навіть шкідливо: усе необхідне вже лежить у файлах зміни (change).
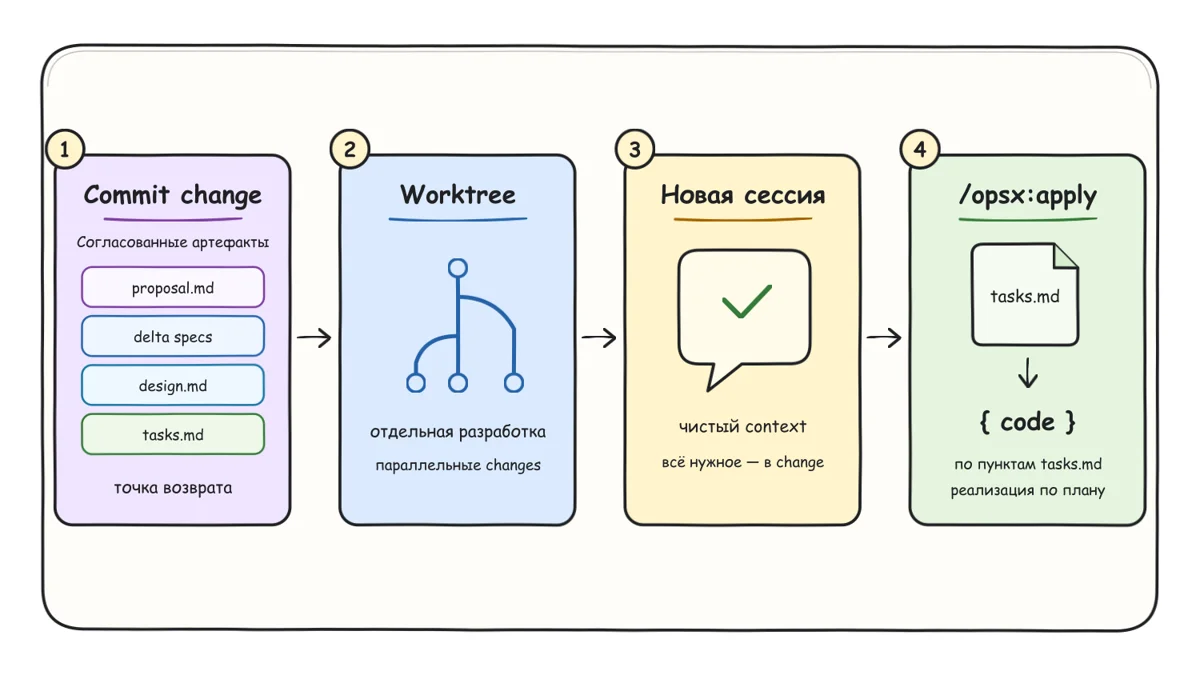
Після цього викликаю /opsx:apply уже із зазначенням конкретної change-специфікації.
/opsx:apply add-vets-crud-apiНа цьому етапі агент уже не планує, а пише код. OpenSpec задає, що потрібно зробити, але не замінює інструкції про те, як це робити в Spring. Тому Spring Skills зберігають свою актуальність: агент, як і раніше, спирається на них, коли створює сутності, репозиторії, DTO та REST-контролери.
Після того як код написано, необхідно зробити його рев'ю. Агент генерує забагато змін, щоб читати кожну однаково уважно, тому дивлюся лише найбільш значущий код: модель, сервіси, репозиторії, db-міграції та тести.
Обов'язково перевіряю наявність автоматизованих end-to-end-тестів та їхню коректність. Якщо автоматизувати деякі end-to-end-сценарії з якоїсь причини неможливо, проходжу їх вручну (або прошу пройти QA). Потім запускаю PITest для щойно написаного або зміненого коду, щоб переконатися, що на етапі розробки агент не пропустив якийсь із важливих сценаріїв.
Закінчивши рев'ю та всі необхідні перевірки, хочеться одразу закомітити зміни, створити PR/MR і рухатися за стандартним процесом. Але зачекайте: ми ще не перетворили delta специфікації на main специфікації. Тому зміни у вихідному коді комітимо, а PR/MR поки не створюємо. Спочатку потрібно виконати синхронізацію специфікацій та архівацію зміни.
Sync & Archive
Навіщо взагалі синхронізувати специфікації? Поки delta специфікації живуть лише всередині зміни (change), main специфікації, як і раніше, описують систему до нашої доопрацювання. Адже саме main специфікації — джерело істини, на яке агент спиратиметься в наступних propose. Якщо їх не оновити, наступна зміна почнеться із застарілої картини світу: агент не побачить уже доданих вимог і або опише їх заново, або спокійно запропонує поведінку, яку ми щойно реалізували інакше. Синхронізація переносить ADDED, MODIFIED і REMOVED із delta специфікацій у main специфікації. Для цього в OpenSpec є спеціальна команда /opsx:sync. Але не поспішайте її викликати.
Річ у тім, що синхронізація — лише половина роботи. Поки зміна лежить у changes/, OpenSpec вважає її незавершеною. Щоб завершити зміну (change), її необхідно заархівувати. Для цього в OpenSpec є команда /opsx:archive.
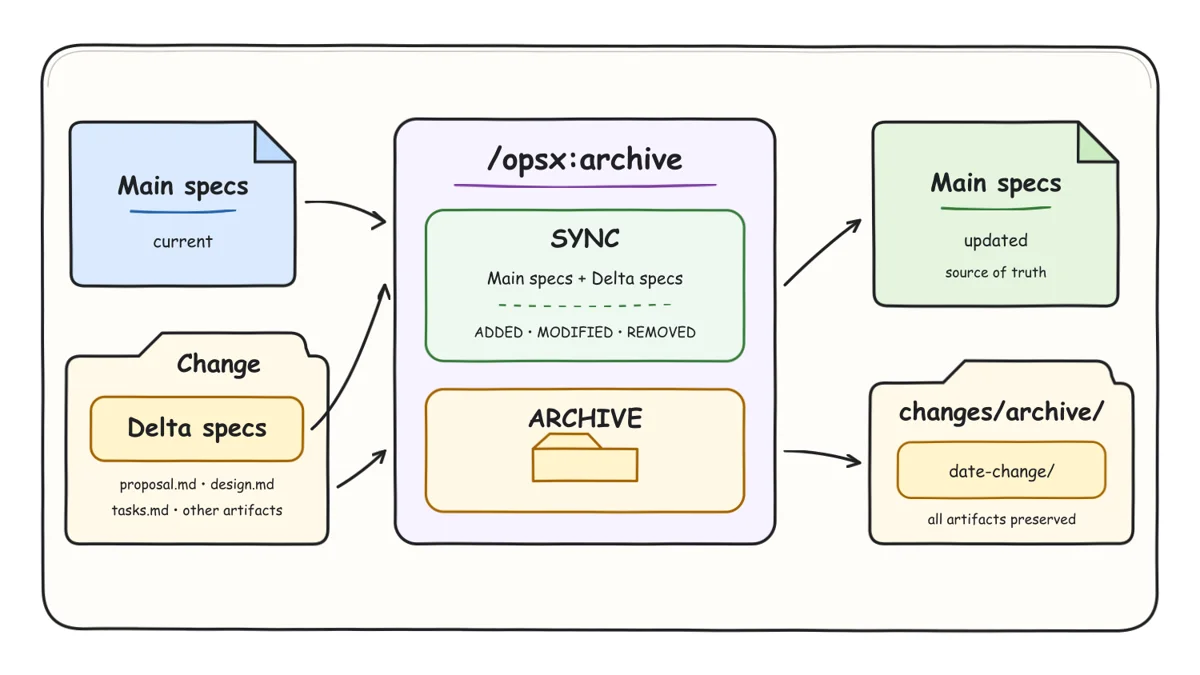
У процесі архівації агент, по-перше, виконує синхронізацію delta специфікацій із main специфікаціями, а по-друге, переносить каталог зміни (change) у changes/archive/ із поточною датою. Proposal, design, tasks і delta специфікації, а також інші артефакти нікуди не зникають: до них завжди можна буде повернутися пізніше.
Так само, як і перед apply, я очищаю поточну сесію або заводжу нову та викликаю /opsx:archive із зазначенням назви зміни.
/opsx:archive add-vets-crud-apiКомітимо результати синхронізації та архівації, створюємо PR/MR, виконуємо решту кроків стандартного процесу розробки та переходимо до наступного завдання, починаючи з кроку propose. Так ми проходимо повний цикл внесення зміни з OpenSpec.
Висновок
Тепер ми знаємо все необхідне, щоб почати вести розробку з OpenSpec: як влаштовані вимоги та специфікації, чим main specs відрізняються від delta specs і як зміна проходить через етапи Propose, Apply та Archive.
Щоб спробувати SDD та OpenSpec зокрема, не обов'язково починати новий проєкт: OpenSpec можна підключити на будь-якому етапі життєвого циклу застосунку. Візьміть одну невелику фічу зі зрозумілими межами та пройдіть повний цикл внесення змін.
Коментарі